陈子瑶chenziyaos

我是一名 SRE,日常做线上稳定性:容灾演练、存储高可用治理、稳定性数据。 业余从零学大模型、按章拆 LLM 推理引擎和 GPU 优化,配套代码在 CPU 上就能跑;另做了一个管理 agent 上下文的画布工具 Weft。

Weft

让模型读到的上下文看得见、改得动。

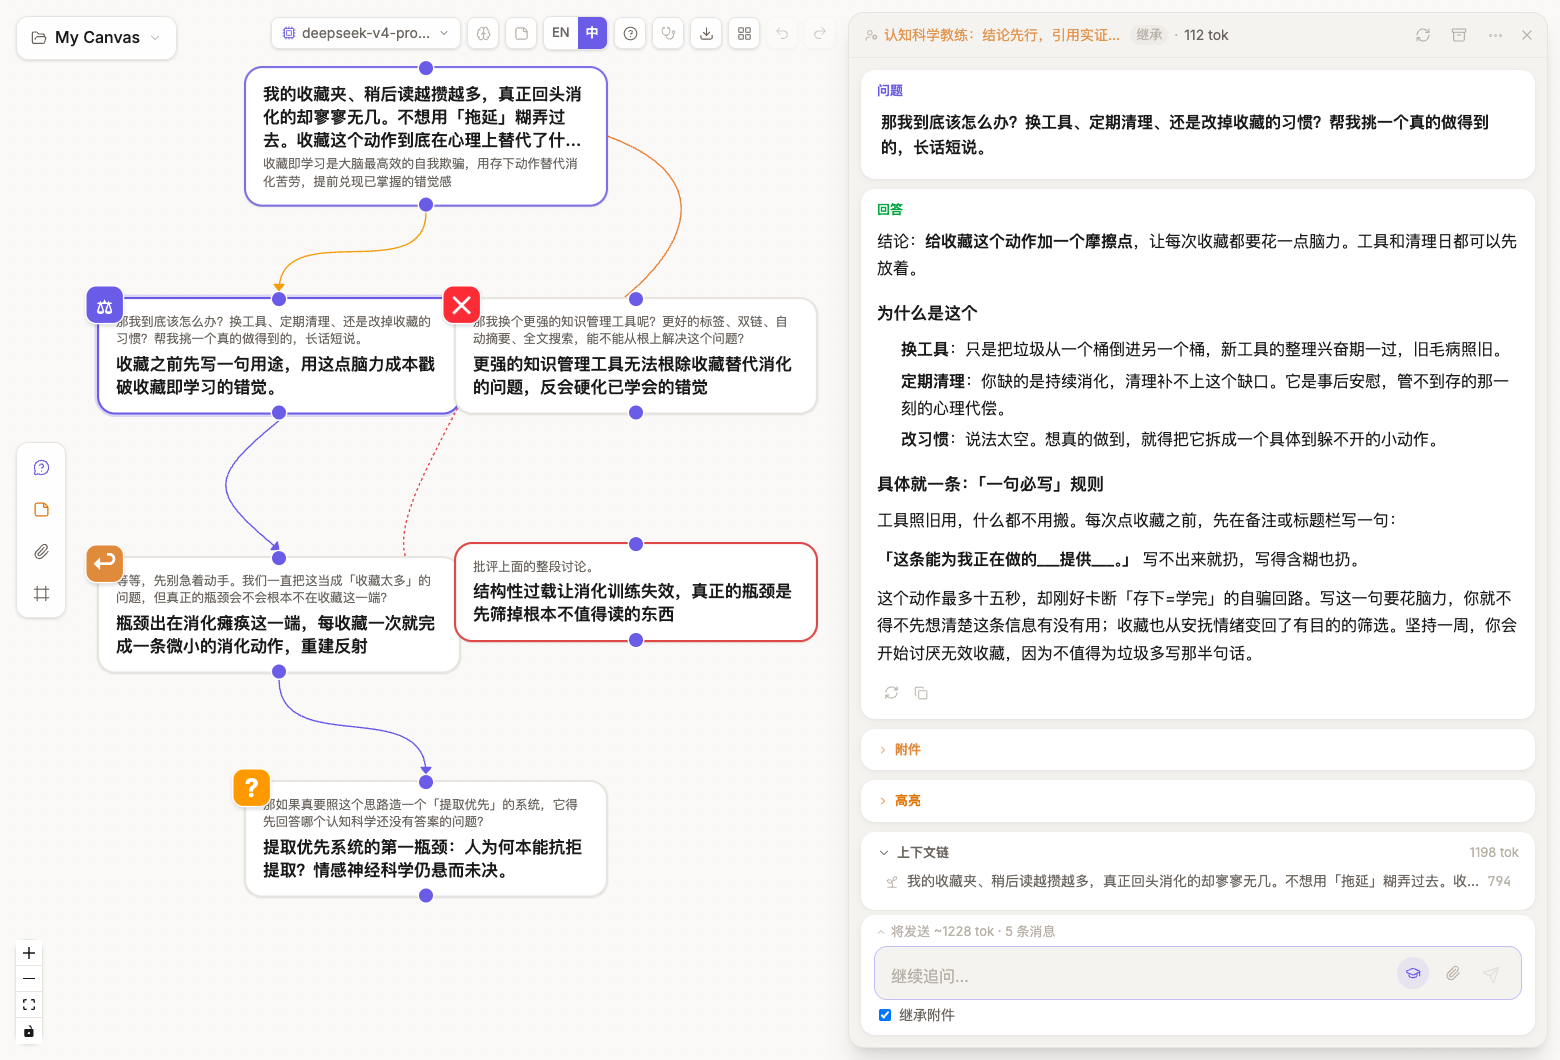
Weft 画布:对话节点之间的连线就是下一轮的上下文

无限画布上的对话,连线就是上下文

每次问答是画布上的一个节点;节点能看到的,恰好是沿箭头流进来的内容。剪掉一条线,下一次回答就变了。

  • 追问与分支:从任意节点继续,或只针对回答里选中的一段开分支,兄弟分支互相看不见。
  • 发送前看清请求:输入框上方显示将发送多少 token、多少条消息,可以展开成完整请求。
  • 改上下文就是改连线:剪断、改接、插入一步,再按依赖顺序重放受影响的节点。
  • 接终端 agent:Claude Code / Codex 会话可以打开成画布镜像来修剪、分支,原会话文件不被改写。
# 不 clone 也能用:npm 包带画布、代理和 weft 命令
npm install -g weft-canvas
weft serve   # http://localhost:3001

Weft fork 自 Xia Chen 的 ThoughtDAG(MIT):画布本身来自上游,本仓库新增了 weft 命令、Agent Skill 和让终端 agent 改画布的实时桥。

「从 0 开始」系列

按章拆解的学习材料,书稿是 Markdown,放在各仓库的 book/ 下。zero-to-llm 是从数学到交付的大模型基础课,正文代码可以逐字复算;另外四套拆推理引擎和 GPU,每章一个代码目录,配能在 CPU 上跑的模拟器或实验脚本、单元测试和 Colab notebook。

zero-to-llm 从零掌握大模型

从矩阵乘法一路讲到推理服务、RAG、Agent 和工程交付,七层由浅入深。每个技术决策都落到效果、显存、时延、成本四笔账上算清楚;正文里的表格和结论都来自代码的真实输出。

  • 数学
  • 模型
  • 训练
  • 后训练
  • 系统
  • 工程
  • 交付
  • 书稿30 篇正文 + 1 篇总览(ZTL-00)
  • 配套代码81 段可运行代码,tools/verify.py 逐段运行并和正文贴出的输出逐字核对
  • 运行环境只要 CPU;Python ≥ 3.10,部分篇要 PyTorch CPU 版,其余只要 NumPy 或标准库
  • 注意后半部分案例里的准确率、时延、成本读数是示意,不是实测,正文已标明
章节目录(30 章)
  1. 01数学符号、向量与矩阵乘法
  2. 02数学条件概率、softmax 与采样
  3. 03数学熵、交叉熵、困惑度与 KL
  4. 04数学链式法则与 softmax-交叉熵的梯度
  5. 05数学优化、归一化与数值稳定
  6. 06数学一张纸算清算力、显存与缩放
  7. 07模型亲手实现分词
  8. 08模型把注意力写成矩阵
  9. 09模型让模型知道顺序
  10. 10模型组装小模型并让一个批次下降
  11. 11训练从语料到一轮小预训练
  12. 12训练多卡的账和中断后续上
  13. 13后训练奖励、策略梯度与 DPO 的数学
  14. 14后训练只对该学的回答算损失
  15. 15后训练只训练一小部分参数
  16. 16后训练用偏好对核对 DPO
  17. 17后训练先验证奖励再训练
  18. 18后训练多想一会儿是否值得
  19. 19系统判断慢在哪,以及请求怎样排队
  20. 20系统减少注意力的内存搬运
  21. 21系统用精度换内存要付什么代价
  22. 22系统让草稿减少解码开销
  23. 23系统把模型部署成服务
  24. 24系统长上下文与混合专家怎样改变账单
  25. 25工程先把相关材料找出来
  26. 26工程让回答有可追溯的依据
  27. 27工程提示、路由与工具边界
  28. 28工程先写评测再改系统
  29. 29工程Agent 的循环、记忆、权限与成本
  30. 30交付交一个可复查的项目

zero-to-vllm 从 0 开始 vLLM

按章拆 vLLM:显存账本、调度与抢占、Paged KV、前缀缓存、PD 分离、LoRA,再到 DeepSeek / Qwen 部署实战和 Embedding / Rerank 服务。

  • 上手
  • 原理
  • 规模
  • 生产
  • 前沿
  • 实战
  • 专题
  • 书稿26 章
  • 配套代码26 个章节目录,26 个 Colab notebook
  • 版本基线vLLM v0.32.0,主干提交 0d6f92a(2026-10-29)
  • 运行环境sim_*.py 在 CPU 上跑(Python ≥ 3.11);gpu_*.py 和起服脚本要 GPU
章节目录(26 章)
  1. 01上手第一个服务:安装、vllm serve 与读懂启动日志Colab
  2. 02上手推理账本:gpu_memory_utilization、KV 容量与 RooflineColab
  3. 03上手指标与压测:vllm bench serve、TTFT、TPOT 与 goodputColab
  4. 04原理请求旅程:API server、EngineCore 与 GPU workerColab
  5. 05原理调度器:token 预算、num_computed_tokens 与抢占Colab
  6. 06原理Chunked prefill 与异步调度:一步装多少 tokenColab
  7. 07原理PagedAttention:BlockPool、块表与 KV 分配Colab
  8. 08原理前缀缓存与混合 KV 管理:块哈希、驱逐与 JengaColab
  9. 09原理Model Runner、torch.compile 与 CUDA GraphColab
  10. 10原理注意力后端:FlashAttention、FlashInfer、Triton 与 MLAColab
  11. 11规模并行:TP、PP、DP、EP 与 EPLB、DCPColab
  12. 12规模量化:FP8、INT4、NVFP4 与 KV cache 量化Colab
  13. 13规模投机解码:EAGLE、MTP、n-gram 与拒绝采样Colab
  14. 14规模KV 卸载与连接器:CPU 卸载、LMCache 与 MooncakeColab
  15. 15规模PD 分离:NIXL、KV 传输与 P/D 感知路由Colab
  16. 16规模结构化输出与多 LoRAColab
  17. 17生产调参手册:预算、显存比例、编译档位与负载画像Colab
  18. 18生产可观测与 profiling:指标口径、torch profiler 与 nsysColab
  19. 19生产集群与 RL:路由、K8s 部署、sleep mode 与权重同步Colab
  20. 20生产读源码与提 PR:插件系统、测试与基准Colab
  21. 21前沿一个月主干复盘:MRV2 收口、投机解码组合与 KV 状态协议Colab
  22. 22前沿DeepSeek 开源如何改写 vLLM:从 MLA、Wide-EP 到 DeepInfer 同源Colab
  23. 23实战DeepSeek-V4.1-Flash 部署:消费级显卡与 H20Colab
  24. 24实战Qwen3-32B 部署:从 4090 到 H20Colab
  25. 25实战Qwen3.8-27B 部署:混合注意力的显存账Colab
  26. 26专题Embedding 与 Rerank 服务:只有 prefill 的引擎怎么配Colab

zero-to-sglang 从 0 开始 SGLang

按章拆 SGLang:内存池与页表、RadixAttention、overlap 调度与 CUDA Graph、HiCache 三层 KV 缓存、PD 分离、Embedding / Rerank 服务。

  • 上手
  • 原理
  • 实战
  • 前沿
  • 专题
  • 书稿25 章
  • 配套代码24 个章节目录,24 个 Colab notebook
  • 版本基线SGLang v0.5.22,主干提交 8fabf5e(2026-10-28)
  • 运行环境CPU 练习需要 Python ≥ 3.10 + numpy
章节目录(25 章)
  1. 01上手第一个服务:安装、启动、发请求和读懂启动日志Colab
  2. 02上手推理账本:显存、KV 与 RooflineColab
  3. 03上手指标与压测:TTFT、TPOT、ITL 与 goodputColab
  4. 04原理请求旅程:从 HTTP 到流式返回Colab
  5. 05原理调度器:waiting、running 与 KV 预算Colab
  6. 06原理Chunked prefill:切块大小、mixed chunk 与 TTFT / ITL 的取舍Colab
  7. 07原理内存池与页表:req_to_token、token_to_kv 与 page sizeColab
  8. 08原理RadixAttention:基数树的匹配、插入、加锁与驱逐Colab
  9. 09原理Overlap 调度与 CUDA Graph:把 CPU 开销藏到 GPU 后面Colab
  10. 10原理注意力后端:FlashInfer、FA3、Triton、TRTLLM 怎么选、怎么接进 CUDA GraphColab
  11. 11原理并行:TP、DP Attention、EP 怎么组合Colab
  12. 12原理量化:FP8、INT4 与 KV 量化怎么选Colab
  13. 13原理投机解码:EAGLE、MTP、NGRAM 怎么选、怎么调Colab
  14. 14原理HiCache:显存、主机内存、远端存储三层 KV 缓存Colab
  15. 15原理PD 分离:prefill 和 decode 拆到两组卡上Colab
  16. 16原理结构化输出与多 LoRA:约束解码和 adapter 批处理的代价Colab
  17. 17实战参数调优手册:从日志倒推配置Colab
  18. 18实战可观测与 profiling:从指标到 kernelColab
  19. 19实战集群与 RL rollout:路由、权重同步与长尾Colab
  20. 20前沿42 天主干复盘:缓存寻址、PD 状态与投机解码的组合边界Colab
  21. 21前沿DeepSeek 开源如何改写 SGLang:从 kernel 到 DeepInferColab
  22. 22实战DeepSeek-V4.1-Flash:消费级显卡与 H20 上的 SGLang 部署Colab
  23. 23实战Qwen3-32B:单卡到两卡的 SGLang 部署,以及迁到 Qwen3.8-27BColab
  24. 24实战Qwen3.8-27B:混合 GDN 视觉模型的 SGLang 部署
  25. 25专题Embedding 与 Rerank 服务:只有 prefill 的引擎怎么配Colab

zero-to-llama 从 0 开始 llama.cpp

按章拆 llama.cpp:GGUF / GGML 结构、内存与带宽预测器、量化对照、CPU 调优、投机解码。实测数字来自一台 4 vCPU / 8 GB、没有 GPU 的机器。

  • 上手
  • 内部
  • 实战
  • 书稿22 章
  • 配套代码22 个章节目录,22 个 Colab notebook
  • 版本基线llama.cpp v0.8.0,主干提交 0ec4027(2026-10-30),ggml 0.28.0
  • 运行环境Python ≥ 3.9 标准库,不装 gguf 包也能读 GGUF
章节目录(22 章)
  1. 01上手第一次运行:编译、转换、加载和读懂内存账单Colab
  2. 02上手推理账本:带宽、算力和启动前算出速度上限Colab
  3. 03上手测量方法:llama-bench、PPL、KLD 和噪声Colab
  4. 04内部GGUF:文件结构、元数据、加载方式和分卷Colab
  5. 05内部ggml 与计算图:建图、内存规划、调度和复用Colab
  6. 06内部后端与编译:CPU 变体、BLAS、repack 和 GPU 架构Colab
  7. 07内部量化:块结构、配方、imatrix 和用 KLD 选类型Colab
  8. 08内部KV cache 与长上下文:账本、深度、量化、SWA 和上下文写满Colab
  9. 09内部采样、语法与聊天模板:截断链、温度、惩罚、GBNF 和模板Colab
  10. 10内部CPU 调优:线程、绑核、repack、加载方式和带宽上限Colab
  11. 11内部GPU 卸载与 MoE:-ngl、专家放置、fit 和专家缓存Colab
  12. 12内部多卡与 RPC:-sm layer、流水线、张量并行和 RPCColab
  13. 13内部投机解码:草稿模型、n-gram 和拒绝采样Colab
  14. 14内部服务端:槽位、连续批处理和提示缓存Colab
  15. 15内部多模态:mmproj、图片切块和音频Colab
  16. 16内部路由与运维:多模型、预设、内存余量和监控Colab
  17. 17内部调参手册:默认值、误配、按症状查参数和上线清单Colab
  18. 18内部新模型接入:转换、计算图和逐层对拍Colab
  19. 19内部测试与贡献:ctest、test-backend-ops、性能对比和 PRColab
  20. 20实战24 GB 单卡:Qwen3-32B 和 Qwen3.8-27BColab
  21. 21实战一台机器跑 DeepSeek-V4.1-FlashColab
  22. 22实战一张卡跑 Qwen3.8-27BColab

zero-to-gpu 从 0 开始 GPU 优化

从硬件到集群:性能账本、访存与 GEMM、Tensor Core、PCIe / NVLink / RDMA、NCCL、K8s 调度、可靠性、MoE 专家并行和推理系统。

  • 硬件
  • 系统
  • 单机
  • 集群
  • LLM
  • 书稿33 章
  • 配套代码24 个章节目录,24 个 Colab notebook
  • 版本基线CUDA 13.4 Update 2,PyTorch 2.15.0,NCCL 2.32.3
  • 运行环境sim_*.py 在 CPU 上跑(Python ≥ 3.10 + numpy);*.cu 和 gpu_*.py 要 GPU
章节目录(33 章)
  1. 01硬件GPU 架构:SM、存储层级与延迟隐藏Colab
  2. 02硬件性能账本:Roofline、算术强度与三类瓶颈Colab
  3. 03硬件CUDA 编程模型:线程层级、stream 与编译链Colab
  4. 04硬件访存与归约:合并访存、共享内存与 warp 归约Colab
  5. 05硬件GEMM 逐步优化:从朴素循环到 warp 分块Colab
  6. 06硬件Tensor Core 与低精度:从 mma 到 FP8 和 FP4Colab
  7. 07硬件Triton、CUTLASS 与 CuTe DSLColab
  8. 08硬件注意力内核Colab
  9. 09系统驱动、CUDA 兼容与 XidColab
  10. 10系统显存管理Colab
  11. 11系统PCIe、NUMA 与 GPUDirectColab
  12. 12系统MIG、MPS 与容器Colab
  13. 13单机NVLink 与 NVSwitchColab
  14. 14单机性能分析与 ProfilingColab
  15. 15单机PyTorch 运行时Colab
  16. 16单机单机验收与调优Colab
  17. 17集群RDMA 网络:InfiniBand、RoCE 与拥塞控制Colab
  18. 18集群NCCL:算法、协议与挂死排查Colab
  19. 19集群Kubernetes 上的 GPU:设备插件与拓扑感知调度Colab
  20. 20集群可靠性与可观测:故障、静默错误与 checkpointColab
  21. 21LLM训练并行:TP、PP、DP、ZeRO 与 FP8Colab
  22. 22LLMMoE 与专家并行:all-to-all 与负载均衡Colab
  23. 23LLM推理系统:KV cache、PagedAttention 与 PD 分离Colab
  24. 24LLM综合:从选卡到上线Colab
  25. 25LLM投机解码:αK 与 MTP / EAGLE 谱系
  26. 26系统CXL:一致性互连与 KV offload 工程化
  27. 27硬件NVL72 与 Grace-Blackwell Superchip:打穿 TP=8
  28. 28LLM推理成本经济学:$ per token 与集群单卡经济
  29. 29LLM推理引擎实战:SGLang vs vLLM 选型
  30. 30LLM线性注意力与 KDA:KV 消失之后的 serving
  31. 31LLMAgent Workload Serving:会话原语与约束解码
  32. 32LLMRubin 时代与 Dynamo 推理:Blackwell 之后的时间账(2026)
  33. 33LLMTensor Core 三代跃迁:Volta→Turing→Ampere→Hopper,为什么每代都要重写 kernel

30 秒试一下

不需要 GPU,也不需要装推理引擎。

算一张 H100 上 vLLM 能分到多少 KV 缓存

git clone https://github.com/chenziyaos/zero-to-vllm.git
cd zero-to-vllm/02-ledger
python3 sim_ledger.py --model qwen3-8b --gpu h100-sxm

期望输出的开头:

Qwen3-8B on 1 x H100 SXM  weight=bf16 kv=bf16 util=0.92
  requested          72.86 GiB  (总显存 x util)
  - 权重             15.26 GiB
  ...
  = KV 可用          55.43 GiB  ← 对照日志 Available KV cache memory

算四个代表模型每个词元占多少 KV 缓存

git clone https://github.com/chenziyaos/zero-to-llm.git
cd zero-to-llm
python3 01-matmul/ex07.py      # 只用标准库
python3 tools/verify.py 01     # 第 01 篇全部代码和正文输出逐字核对;需要 NumPy

期望输出的开头:

Qwen3-32B     262144 B/token =  256.0 KiB/token
Qwen3.8-27B    65536 B/token =   64.0 KiB/token
DeepSeek-V3    70272 B/token =   68.6 KiB/token
Kimi K3        27648 B/token =   27.0 KiB/token
...

不想在本地装环境:四套引擎和 GPU 系列有 Colab

每章的 notebook 依次做四件事:克隆仓库、装 requirements-cpu.txt、跑本章单元测试、跑正文里的 CPU 命令。

各章 notebook 的入口也在上面每套系列的「章节目录」里。

使用前要知道的

  • zero-to-* 是学习用的配套代码,不是库。模拟器复现的是引擎主干里的关键账本,结果要和真实日志对账才算数。四个引擎和 GPU 仓库的 README 写了版本基线(具体到 commit),换了版本数字可能对不上。
  • zero-to-llm 后半部分的案例读数是假设读数。准确率、时延、成本这些案例数字是示意用的,不是实测;能复算的是代码输出和公式推导,正文里都标明了。这个仓库没有 Colab notebook。
  • Colab notebook 只放 CPU 能跑的命令。要 GPU、模型文件或运行中服务的命令没有放进去,要自己找机器跑。
  • 部分大模型章节还没有 GPU 实测。例如 llama.cpp 系列的双模型部署层只做启动前的字节推算,实测前标为 pending_gpu_measurement;以各章正文的说明为准。
  • Weft 的画布数据存在浏览器 IndexedDB 里,没有同步也没有账号,用「导出备份(.json)」备份。桌面安装包未签名,限制和排障见它的 README。
  • 2015–2020 的仓库不再维护: ngx_stream_upstream_check_module(Nginx stream 模块的 TCP 健康检查)、 onssh(基于 SSH 的 Web 终端,Python 2.7 + Tornado)、 nginx-devops。