
上手 Weft
模型怎么回答,取决于它读到了什么;而在一段越拉越长的对话里,这部分恰恰看不见。聊到几十上百轮,被推翻的假设、调试的工具输出、无关的分支,和真正要带着的决策混在一起:回答变味了查不出原因,想去掉一段只能新开窗口重讲背景,交给 Agent 时它读错一段背景,改错的就是代码和文件。会话日志能告诉你 Agent 刚才做了什么,却回答不了另一个问题:下一轮开始之前,它该带着哪些上下文继续?
Weft 把对话摊在一张画布上:每轮问答是一个节点,节点之间的连线就是上下文。模型能读到什么,画布上一目了然,改线就是改上下文。 在这份手册的实测里,剪掉一条线,分支下一轮要发送的内容就从约 2603 tok 降到约 1384 tok,被剪掉的那一轮不再进入上下文(见第 9 节)。
只有一条规则:连线即上下文
一个节点能看到的,恰好是沿箭头流进它的内容,没有藏起来的历史。这份手册里的每个操作,都是这条规则在起作用:
| 你在画布上做的事 | 模型那边的变化 |
|---|---|
| 追问 | 新节点用实线挂在下面,读得到上面完整的问答链 |
| 开分支 | 同一个问题下的几条线互相看不见 |
| 剪掉一条线 | 那段历史退出上下文,下一次回答随之改变 |
| 把材料或别处的节点连进来 | 连上的进入上下文,没连的不进 |
| 把几条线汇到一个节点 | 合并思路、对照多个模型、汇总多条分支 |
这份手册怎么读
围绕这条规则,Weft 有四项核心能力,手册按这四项分成四部分。全程跟着一个真实的问题往下走:"为什么复盘写了,同样的事故还会再发生"。
| 部分 | 解决什么问题 | 包含的操作 |
|---|---|---|
| 一、画出思路 | 讨论不再只有一条线 | 连上模型、提问、追问、开分支、多模型对照 |
| 二、看清模型读到了什么 | 发出之前看得到,发出之后查得到 | 发送前的完整请求、每版回答的回执、"上游已变" |
| 三、改上下文就是改线 | 想让模型少看或多看一段,直接改线 | 剪线、连线与改接、插入一步、接材料、归档、重放 |
| 四、交给 Agent | Agent 也守同一条规则 | Agent 节点写文件、把 Agent 会话打开成图、让终端 Agent 改画布 |
第一、三、四部分的截图和数字来自 2026-10-12 用真实托管模型完整跑通的一次测试(13 步全部通过;用 node scripts/e2e-user-journey.mjs 可重现)。第二部分和插入一步、会话成图用的是对应功能验收时的截图,节点里是测试数据。原始运行记录不在公开仓库中。
先跑起来
需要 Node 20 或更高版本:
npm install -g weft-canvas                # 安装 weft 命令
weft serve浏览器会自动打开 http://localhost:3001,在首页输入框里写下问题,按回车就行。终端窗口保持开着,按 Ctrl+C 结束。画布保存在这个地址对应的浏览器存储里,所以每次都用同一个地址打开。
也可以从源码运行:clone https://github.com/chenziyaos/weft,在仓库根目录 npm install,再分别运行 npm run server 和 npm run dev,打开 http://localhost:5173。
模型可以用自己的:任意 OpenAI 兼容接口(自建网关、本地模型)或一家服务商的 key 都行,在模型设置里填上即可(见第 1 节)。
想让 Agent 在本地目录里干活,本机还需要装有 codex 或 claude 命令行。Agent 只能在本地代理或桌面版里用;纯网页部署没有能执行任务的机器,所以菜单里不会出现 Agent 分组。
第一部分 画出思路
1. 连上模型
首页中间是提问框,右上角显示当前默认模型。
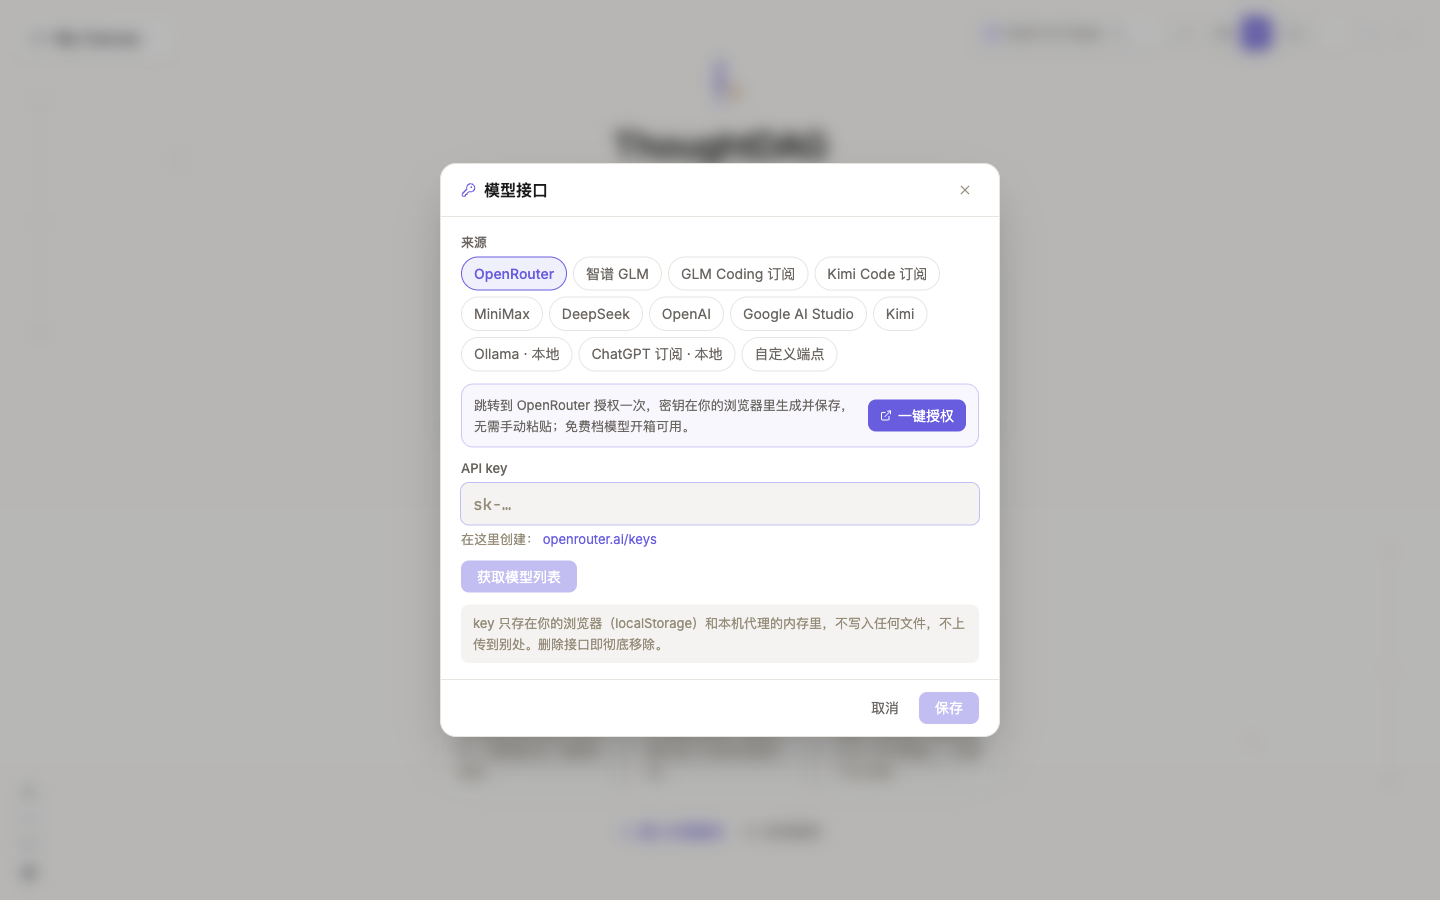
点开模型下拉菜单,选配置模型 API,打开模型接口窗口。点添加接口,选一家预设填 key;或者选自定义端点,填接口地址(以 /v1 结尾的 OpenAI 兼容地址,本地模型也行)和 key,点获取模型列表,勾上要用的模型后保存。
模型下拉菜单分两组:上面是直接回答的模型(所有已连接的模型,标着"视觉"的能看图),下面是 Agent 执行,按 Codex、Claude Code 分组。这里选的是新节点的默认模型,已经生成的节点不受影响。
判断模型也可以自己配:在同一个窗口切到快思考 · 判断模型,提供方选自定义 System One 地址,填自建的 /v1/systemone 接口地址,点测试看到延迟和模型名就接上了;没有这类接口时也可以选一个对话模型来代判断。多模型分支的打分、自动化的决策都会改走它。
2. 问第一个问题
在首页输入框写下问题,按回车。画布上出现第一个节点,回答一边生成一边显示;带思考过程的模型会在回答上方多一栏可以折叠的"思考过程"。
实测的问题是"为什么很多团队写了复盘文档,同样的事故还是一再发生?",默认模型用 58 秒写了 1461 字。
3. 追问:上下文顺着线往下走
双击节点,右侧打开详情面板:上面是问题和回答,底部是"继续追问…"输入框。在这里输入追问,按回车。新节点出现在当前节点正下方,中间是一条实线,表示下面的节点能读到上面完整的问题和回答。
实测追问的是"如果只能改一件事,最该先改什么?"。在第一问下追问时发送 4 条消息:系统附加、第一问的问和答、本次问题。追问答完后,追问节点的下一轮变成 6 条消息、约 2414 tok,多出来的两条就是上面那一轮问答,完整地跟了下来。怎么看到这些数字,见第 6 节。
4. 换个方向:开一条分支
回到第一问,双击打开它的面板,再问一个不同的问题。新问题会成为第一问的另一个子节点,和刚才的追问并排。
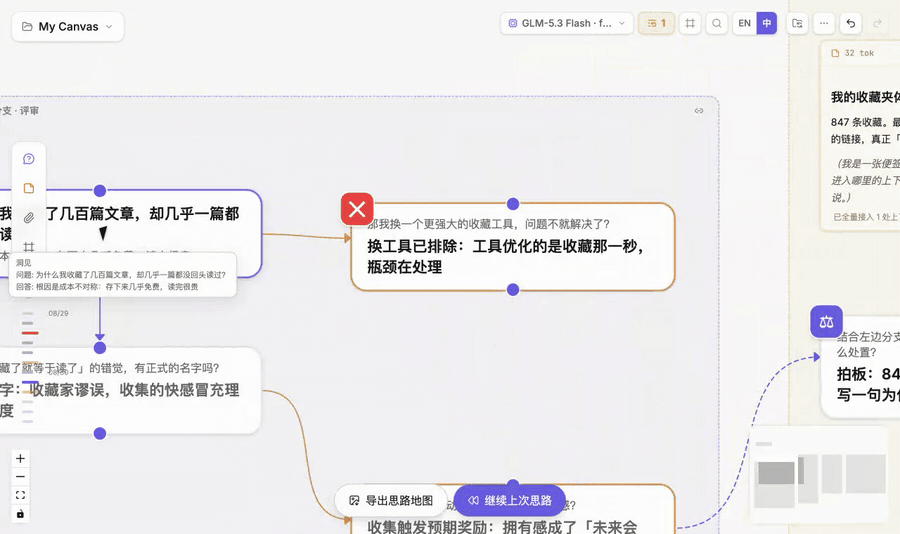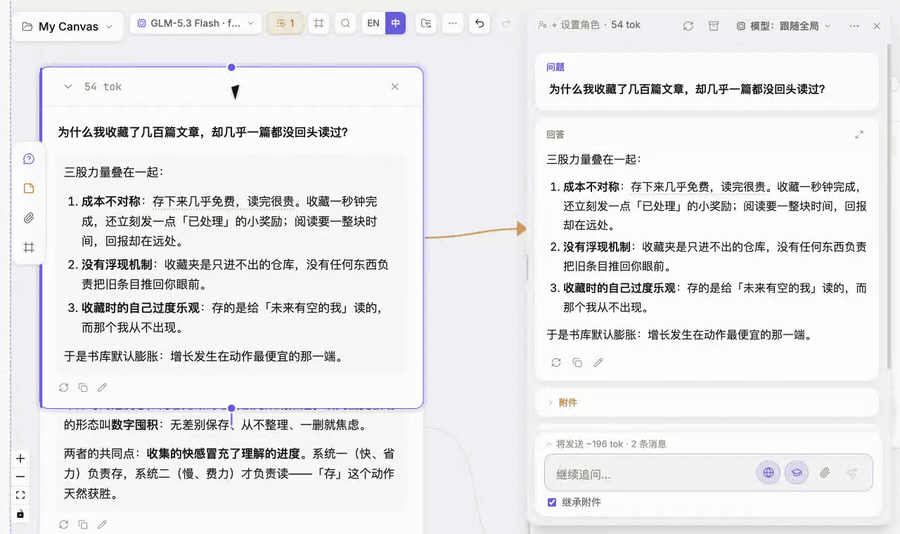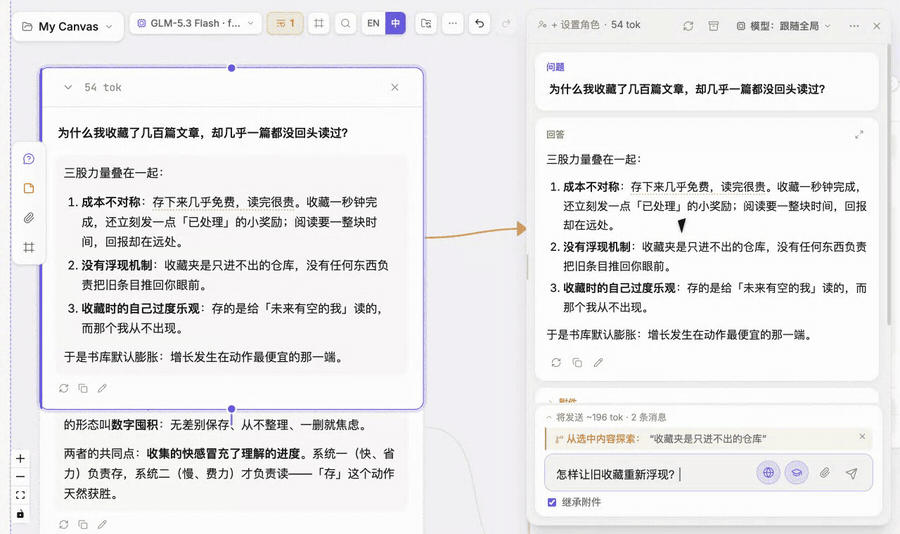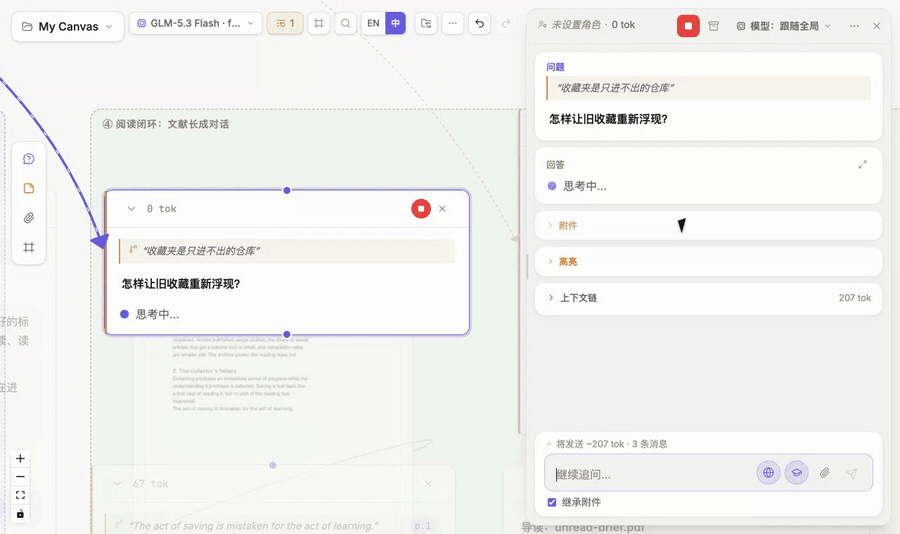
两条分支互相看不见。实测在第一问上开分支时,发送内容仍是 4 条消息,追问那条线一个字也没带进去;分支自己的下一轮是 6 条消息,同样不含另一条线。
追问总是挂在当前面板所在的节点下面:想从哪里分叉,就先打开那个节点的面板。画布上展开的卡片底部也有自己的"继续追问…"输入框,效果一样,新节点挂在那张卡片下面。在回答里选中一段文字,也可以只就这一段开分支。
节点多了以后,点右上角 更多 → 一键排版,画布会按连线方向重新排好:同一条对话链竖着对齐,分支并排展开。排版前会先确认,排完也能用 Cmd+Z 撤销。
5. 让几个模型一起回答
在节点面板右上角点 更多操作 → 添加视角,选多模型对照:
- 在"共同问题"里写下要对照的问题。
- 在"参与的模型"里至少选两个。
- "全部答完后合成"默认勾选:所有模型答完后,会再生成一个汇总节点。
- 点"让 N 个模型作答"。
每个模型在自己的分支上独立作答,看不到彼此的回答,分支底部标着用的是哪个模型。都答完后,汇总节点从每个分支各接一条线进来,这几条线就是汇总节点的全部上下文,没有暗中拼接的内容。
| 模型 | 回答 | 答完用时 |
|---|---|---|
glm-5.3-flash | 183 字 | 4.1 秒 |
kimi-k2.5 | 133 字 | 16.2 秒 |
deepseek-v4.1-flash | 149 字 | 9.1 秒 |
汇总(默认模型 auto) | 1956 字 | 75.6 秒(从点击开始计) |
汇总按固定结构输出:共识、分歧、独到之处、待验证的假设、建议的下一步。
谁答得最好。 分支都答完后,判断模型会在后台读一遍所有分支,给每张卡片的底部标上一枚小标签:答得最好的那个标"★ 最佳",其余标质量分(满分 3),可能没答到点子上的标"⚠ 可能没答好"。鼠标悬停能看到全部数字:答好这个问题的概率、四档质量各占多少、在几个回答里最好的概率。
实测三个模型回答同一个问题,三张卡片都拿到了评分,答好的概率在 84%–93% 之间;另一组测试里,故意写的跑题回答和错误回答分别只有 1% 和 4%。这个分数只作参考:判断模型也会看走眼,所以它不会自动删改任何回答,也不进入任何上下文,汇总节点读到的仍然只是各分支的问答。
换个模型重答。 觉得某个分支答得不好,点它底部的双箭头,选另一个模型重答。上下文不变,新回答追加为一个版本,原回答保留,可以来回切换;节点自己设定的模型也不变。名字里带 max、pro 这类大号档位的模型排在前面,标着"较强"。重答完,这组分支会重新打一次分。实测把排最后的分支换成 glm-5.3 重答,重新打分后排到了第一。Agent 节点没有这个按钮:重跑会把改文件、跑命令再做一遍。
另外两种模式用的是同一套机制:回答一次让几个角色(比如审稿人、产品经理)各自独立作答;持续评审让角色挂在思路旁边,思路每往前走一步,就重新评审一次。
回到主线:追问、分支、汇合,画出来的每条线都是一股上下文。接下来看这些线到底让模型读到了什么。
第二部分 看清模型读到了什么
6. 发送之前,看完整请求
详情面板底部输入框上方有一行"将发送 ~1337 tok · 4 条消息",就是下一次追问会带给模型的全部内容。系统附加和本次问题也各算一条。
点一下这行字,展开的是这条追问将发送的完整请求,按模型读到的顺序逐条列出:
- 系统附加:当前日期、回答语言、来源标记的说明;模型拿到搜索工具时再多一段引用规则。
- 角色:给这个节点设定的角色。
- 材料、引用、对话:顺着连线流进来的内容,追问链上每一轮问答各占一条。
- 记忆:开着记忆时带上的长期笔记;开着回忆时多一条"发送时检索",检索结果要到发送那一刻才确定。
- 本次问题:你正在输入的内容,连同刚用 @ 提到的节点和刚加的附件。
每条都能点开看全文,底部有复制完整请求。这份预览和实际发出的请求走同一套编译,逐条一致。
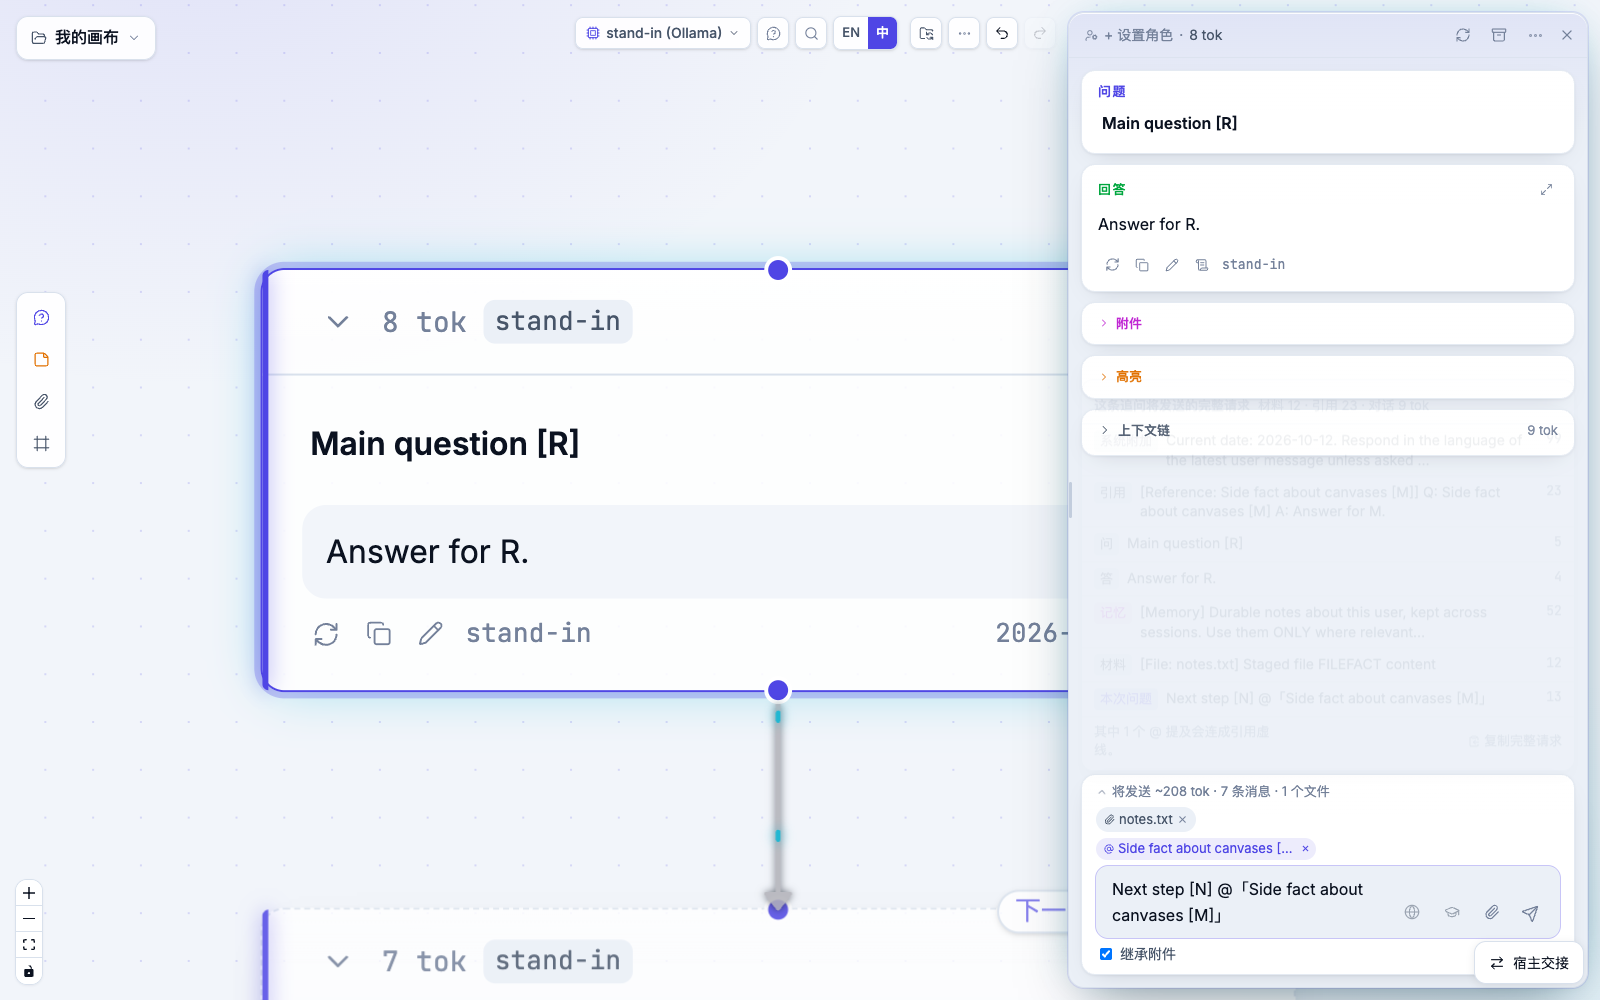
实测追问之后,追问节点的下一轮是 6 条消息,其中对话部分约 2315 tok,两轮问答都在:
花 token 之前,先确认模型这次会看到什么。
7. 发送之后,查这一版回答读了什么
每一版回答都保存了它生成时实际发出的完整请求。回答下方的按钮行里有一个纸卷图标,悬停显示当时读到了什么,点开就是那份请求,格式和发送前的预览一样。
如果之后上游被改过,比如引用的那个节点的回答换了,和这个节点现在会读到的内容不一样的条目会标为现已不同:
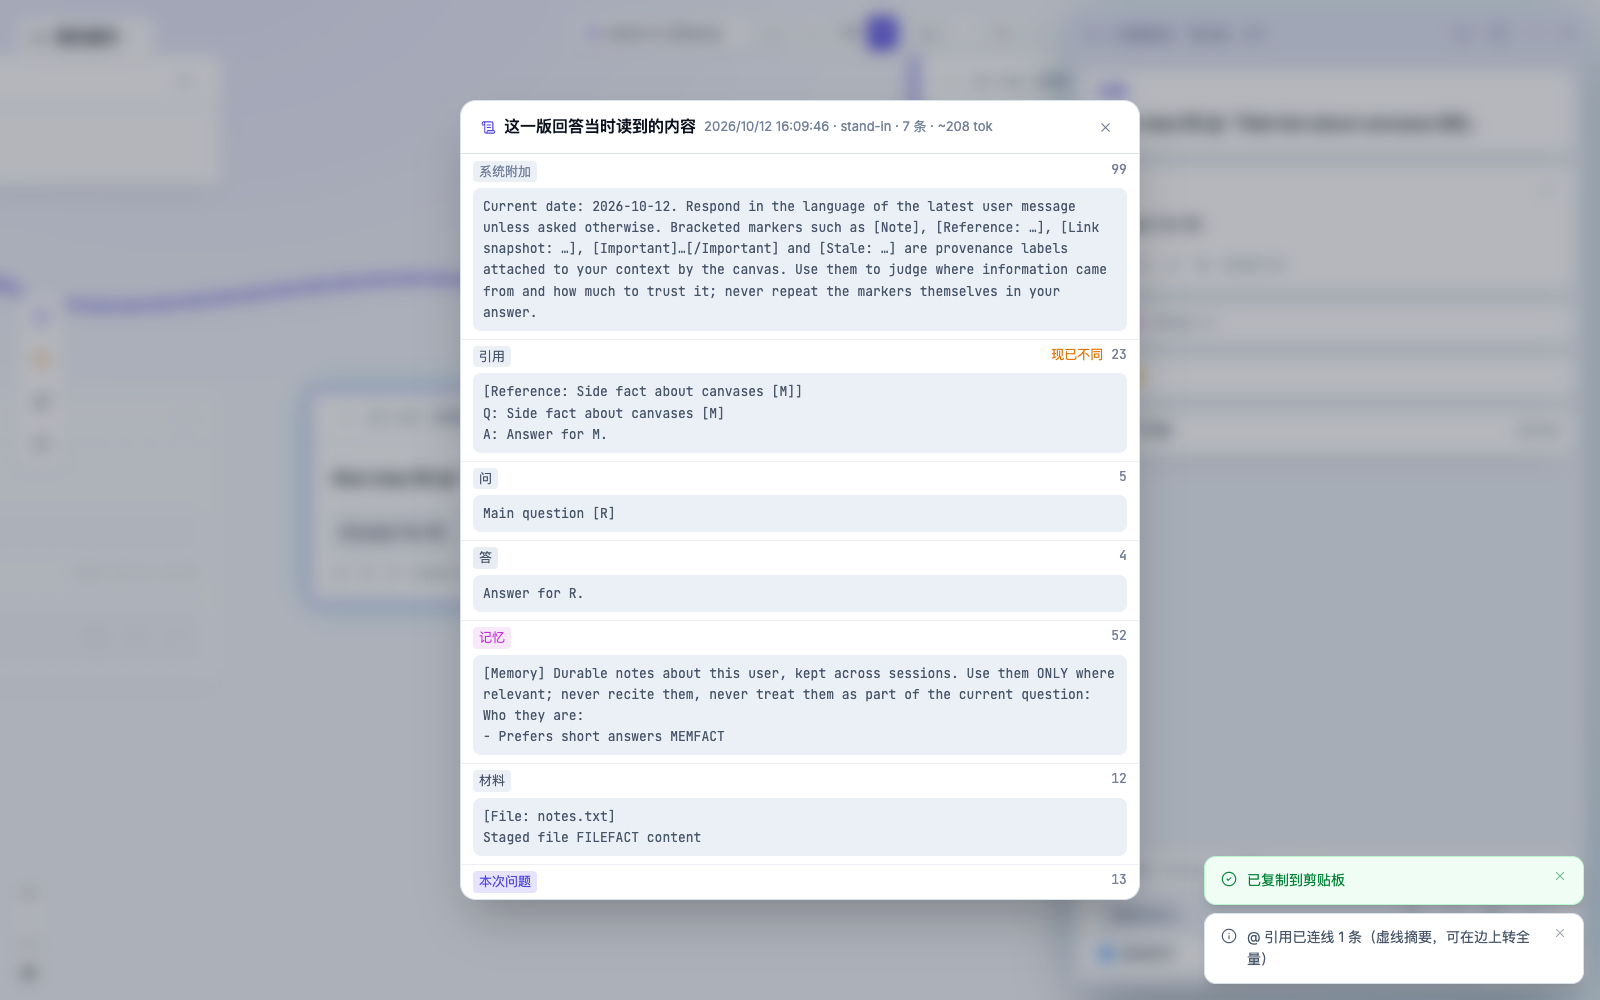
回执保存在本机浏览器里,同样的文本只存一份;导出和分享不包含回执。这个功能上线之前生成的回答,或在别的浏览器里生成的回答,没有回执,窗口里会直接说明。
8. 上游变了,回答会标出来
一个节点生成时记下了它的输入。之后只要上游的问题、回答、连线变了,导致它现在会读到的内容和当时不一样,节点上就会出现上游已变的标记。它的意思是"这个回答是在旧输入下写的",不代表一定错了;打开回执对照一下,再决定要不要重跑(见第 12 节)。
回到主线:发送前看完整请求,发送后查回执,上游变了有标记。模型读到什么,任何时候都查得到。下一步就是改它。
第三部分 改上下文就是改线
9. 剪掉一条线,上下文就少一段
剪线:点一下连线选中它,按 Delete 或 Backspace。实测剪掉第一问通往"怎么衡量"分支的那条线:
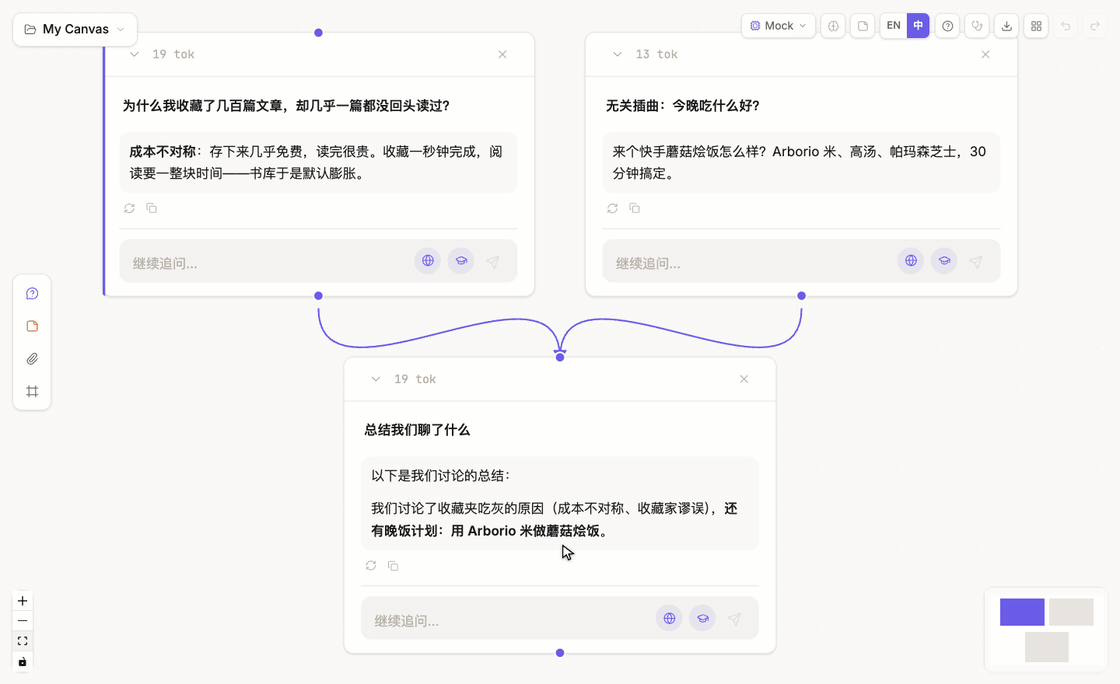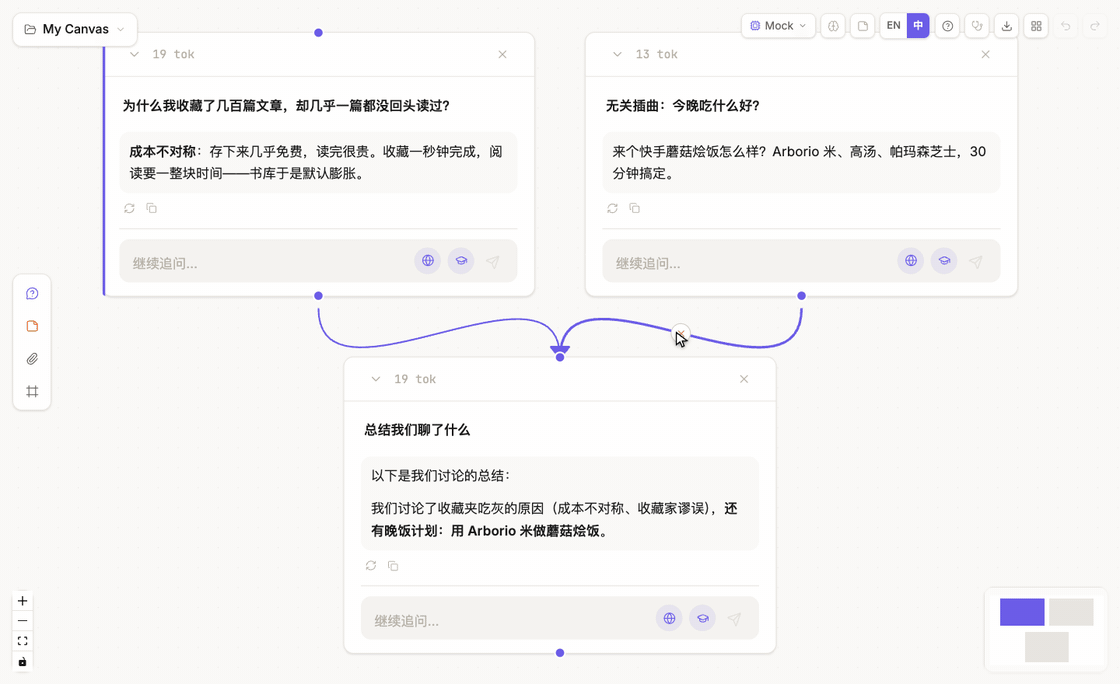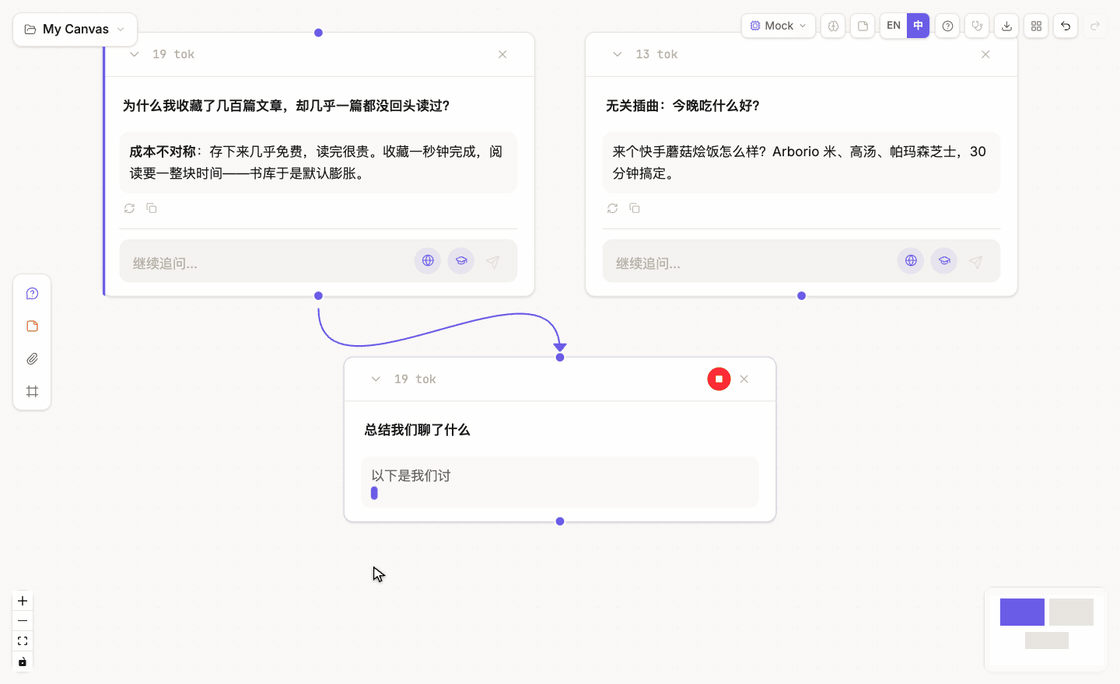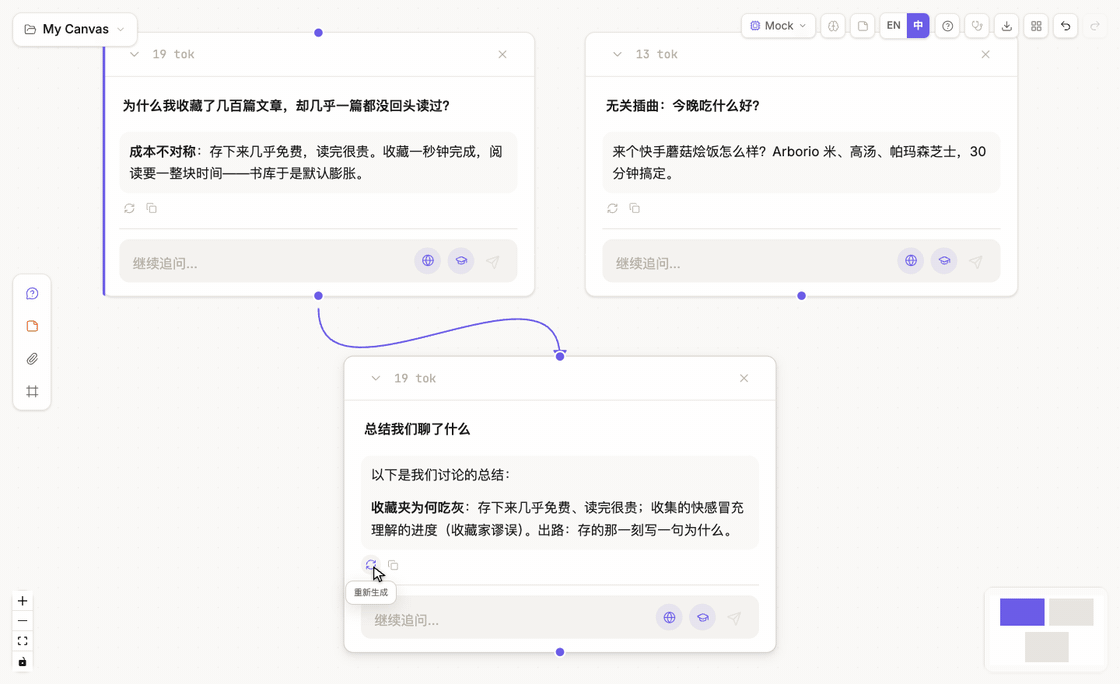
分支卡片上立刻出现"上游已变"的标记。打开它的面板,下一轮要发送的内容从 6 条消息、约 2603 tok,降到 4 条消息、约 1384 tok:第一问那一轮已经不在上下文里了。
剪错了,按 Cmd+Z 就能把线接回来,实测撤销后连线完整恢复。
10. 连线、改接和插入一步
- 连线:从一个节点的手柄拖到另一个节点,两条思路在这里汇合。
- 改接:选中一条线,两端会出现可以拖动的点;把任一端拖到别的节点上,这条线就改接过去,原来的类型和设置不变。会让实线成环、指向材料或框架、和已有连线重复的改接会被拒绝并说明原因;从选中文字分出的线和那段文字绑定,不能改接。
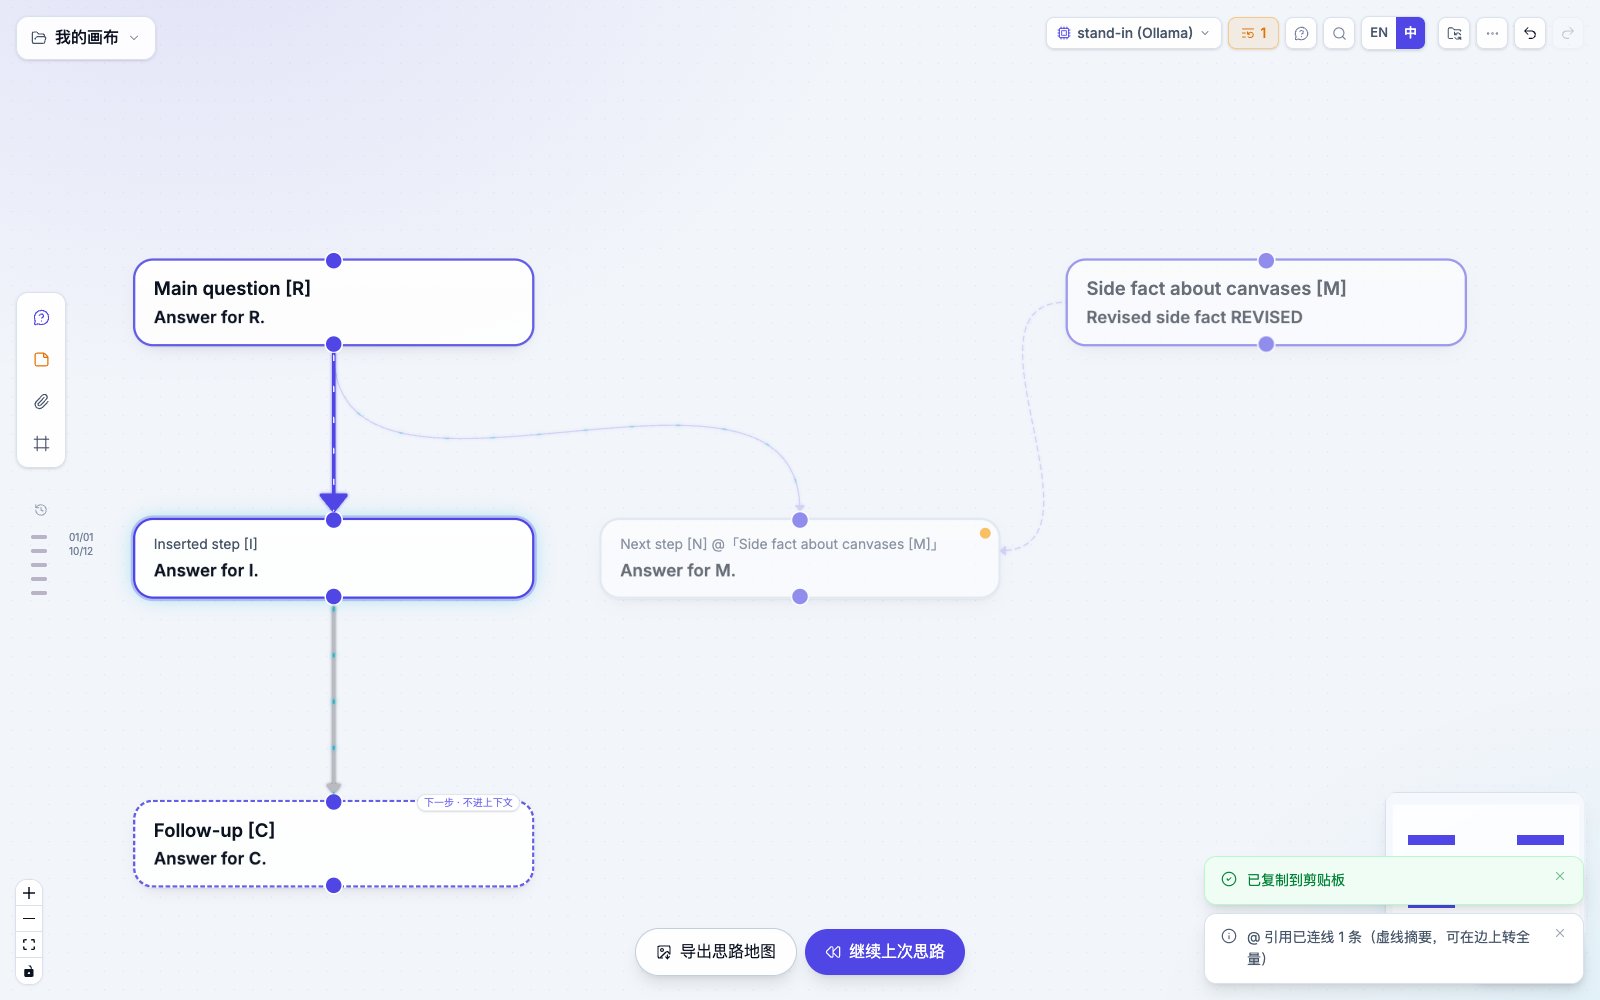
- 插入一步:右键一条实线,选在中间插入一步,输入这一步要问什么,按回车。新节点插在两端之间,原来的下游改为接在新的一步后面,三者仍在同一列;下游因为多读了一步,会标为"上游已变"。
11. 接入材料,以及删除和归档
- 接入材料:粘贴的文字会变成便签,网址变成网页快照,拖进来的文档变成文件节点。材料只有连到问题上才进入上下文,节点上会写明"未连线 · 不进入任何上下文"或已经接入了几处。
- 归档:节点留在画布上,它自己的内容不再进入上下文。
- 删除:删除一个带下游的节点,会连同下游一起删掉。提示里有撤销,改为只归档这一步:点了以后全部恢复,只把这一步归档。
12. 一键重放受影响的节点
改完线以后,画布顶栏会出现一个带数字的橙色按钮,数字是标着"上游已变"的节点数。点它会先确认,告诉你要重跑几个节点、预计发送多少 token;确认后按依赖顺序重跑,上游先、下游后。每个节点追加一个新版本,不覆盖旧回答;上游重跑后输入没变的节点自动跳过,生成失败的节点下游不会运行。中途随时可以停止。
每次改完线,都可以展开"将发送"那一行,确认模型这次实际会看到什么。
回到主线:剪、连、改接、插入、归档,改的都是线;重放让受影响的回答跟上新的上下文。所有改动都能撤销。
第四部分 交给 Agent
13. 让 Agent 在画布里动手
在模型下拉菜单里展开 Agent 执行 → Codex,选一个配置好的模型;有推理强度可选时,确认后菜单会关上。工具栏左侧随即多出一个工作目录按钮,默认是画布工作区:每张画布在 ~/.weft/workspaces/ 下有自己的目录,也可以换成任意本地目录。
然后照常提问。实测的问题是"在当前工作目录创建文件 weft-e2e.md,写入一个三行的复盘行动项清单":Codex 用 12 秒写好了文件,节点上记下了运行时、工作目录和新增的文件。
Agent 读到的上下文和普通节点一样,是顺着连线流进来的内容。这个节点挂在"最该先改什么"那条追问下面,所以它写的行动项接着那条思路。Claude Code 用法相同,在 Agent 执行 → Claude Code 里选一个配置好的模型。
工作目录按钮里还能切换确认模式:默认情况下,Agent 要做需要授权的操作时,节点上会弹出确认卡片,由你批准或拒绝;改成允许后,Agent 直接执行,不再询问。
14. 把 Agent 会话打开成图
你在终端里和 Claude Code、Codex 聊过的会话,也可以打开成一张图:每轮问答是一个节点,工具调用和结果挂在节点的附件里。
- 在首页点或者,打开本机的 Agent 对话,看它们长成图,从列表里挑一个会话。
- 或者在 Claude Code 里输入
/weft(Codex 里是$weft),把当前会话直接在画布里打开。这两个命令由weft setup skill --apply安装;没开服务时会在后台起一个,用weft stop关闭。
打开后,画布跟着会话继续生长:会话里每多一轮,画布上就多一个节点,实测 1.3 秒内同步过来。这是一张镜像,在里面裁剪、开分支、追问,都不会改写原来的会话。
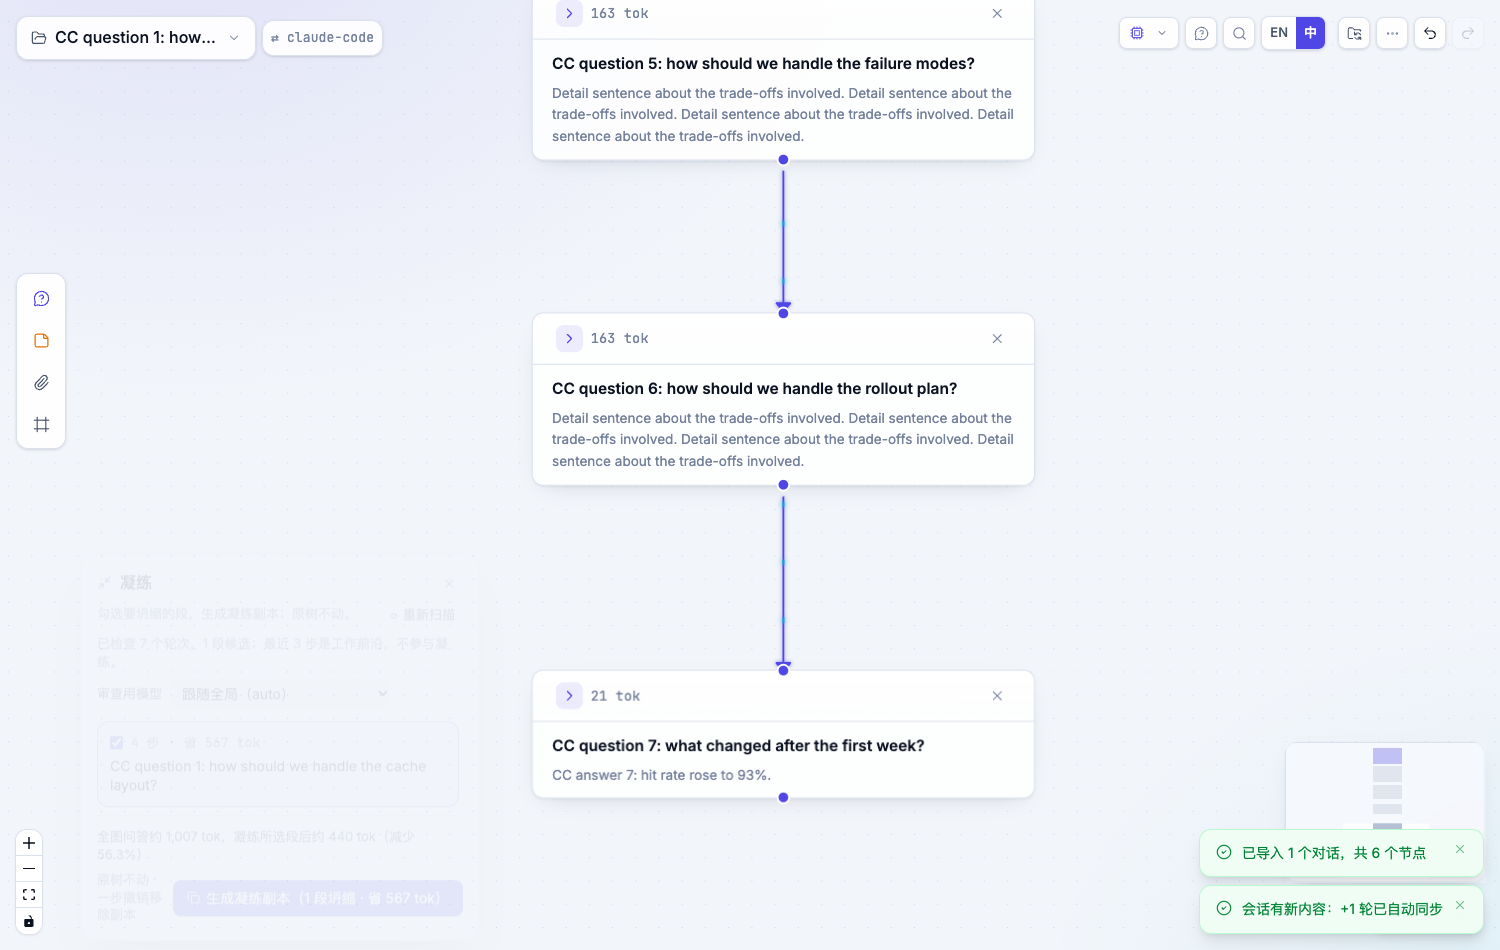
过程太长时,用 ⋯ 菜单里的凝练把冗长的过程收成结论,窗口里会显示全图问答凝练前后的 token 数(实测从约 1007 tok 降到约 440 tok,减少 56.3%)。长会话上效果更明显:一段 141 次提问的真实 Codex 会话,问答约 27.9 万 tok,链上另有 4500 段工具输出约 281 万 tok。更早轮次的工具输出默认不进上下文(只留下动过哪些文件,链尾这一轮自己的照常带上),从链尾追问约 32.4 万 tok,追问框会标黄提示先凝练;凝练 22 段用了 3 分钟,副本的问答降到约 9.5 万 tok,从副本链尾追问约 13.8 万 tok,关掉"继承附件"约 9.5 万 tok,原会话不动。用 node scripts/measure-long-session.mjs 可重现此测量。
想让某一段更早的工具输出也进来,打开节点面板的附件,它们列在"继承自上游"下,标着"更早的工具输出,默认不带";点右边的按钮,就只为这个节点带上那一段。再在节点上右键复制上下文给 CLI 会话,把整理后的上下文粘贴进新的终端会话接着做,那个会话会挂回这张画布。更多用法见 Agent 对话地图。
15. 让终端里的 Agent 直接改画布
如果你本来就在终端里用 Claude Code 或 Codex,也可以让它直接改这张画布,不用来回复制:
- 把 Weft Skill 装进你的项目:先按上面"先跑起来"部分安装命令行工具,再在项目目录里运行
weft setup skill --apply。在 Weft 仓库里也可以先npm run host:build,再运行node scripts/install-skill.mjs --project /你的项目 --hosts claude codex --apply。 - 点画布右下角的 宿主交接,勾选 允许本机 Agent 编辑此画布。按钮旁亮起绿点,就表示开好了。
- 在终端里直接说要做什么。实测说的是"在复盘画布上,从根问题开一个分支问:如果只能改一件事,最该改什么?把证据节点作为引用接进来,然后回答它"。
Agent 会先读画布,再开分支、连引用、作答,并把回答写回节点。新节点按连线方向自动排好;每次修改,画布都会弹出提示,点撤销就能退回,面板里也列着最近的请求。
实测 Claude Code(glm-5.3)用了 45 秒,Codex(gpt-5.3-codex)用了 93 秒,两次都只给了上面那样一句话。
几个 Agent 也可以同时改同一张画布。每个 Agent 只看得到连给自己那个节点的内容,互不串味;两个 Agent 恰好同时提交修改时,后到的那个会被告知画布刚变过,重新读一遍再改,不会覆盖对方。一个 Agent 改了上游的回答,接在下面、由别的 Agent 写的回答会被标上"上游已变"。实测让 Claude Code 和 Codex 同时在复盘画布上各开一个分支作答,分别用了 96 秒和 130 秒,中途 Codex 遇到一次冲突,重新读取后照常完成。画布只接受本机发来的请求;刷新、关闭页面或取消勾选后,Agent 就改不了了。
想在终端里查"这个文件是哪几轮对话改的、当时为什么这么改",用 weft why <文件>,见 Why 层。
回到主线:Agent 节点、会话镜像、终端 Agent,读到的都只是连进来的内容。同一条规则,从画布一直延伸到你的终端。
导出和备份
右上角 更多 菜单里有两种导出:
- 导出备份 (.json):完整的画布,换台机器可以原样导入。
- 导出为双链笔记 (.zip):每个节点一个 Markdown 文件,解压出来的文件夹可以直接当 Obsidian 库打开。实测导出了 9 个文件(8 个节点加 1 个索引页)。
每篇笔记开头是元数据,问题写成 callout,正文是回答原文,末尾用 [[双链]] 写明前后关系:
---
weft_id: "node-1791735081724-1"
kind: thought
created: 2026-10-11T16:11:21.724Z
generated: 2026-10-11T16:12:14.334Z
tags: [weft]
---

> [!question]
> 如果只能改一件事,最该先改什么?给出可落地的做法。

如果只能改一件事,那绝不要动"怎么写文档",也不要搞"培训洗脑"。……

## 承接自
- [[为什么很多团队写了复盘文档,同样的事故还是一再发生?]]

## 后续
- [[在当前工作目录创建文件 weft-e2e.md,写入一个三行的复盘行动项清单(Markdown 列表),然后用一句话告诉]]画布本身会自动保存在浏览器本地(IndexedDB)。实测刷新页面后,8 个节点都还在。回答的回执也存在本机,不随导出带走。
常见问题
| 现象 | 原因与处理 |
|---|---|
| 模型菜单是空的 | 还没添加任何模型连接。打开模型接口窗口,点添加接口,配置一个模型提供商 |
| 模型接口窗口按 Esc 关不掉 | 点窗口右下角的关闭 |
| 双击节点没有打开面板 | 节点不在可视范围内。先用左下角的"适应视图"或滚轮把它移进来,再双击 |
| 追问挂到了意料之外的节点下面 | 追问总是挂在当前面板所在的节点下。先打开要分叉的那个节点,再输入 |
| 回执窗口写着"这一版没有保存请求" | 这一版回答生成于回执功能上线之前,或在别的浏览器里生成 |
| 拖动连线的一端没有改接成功 | 看弹出的提示:会成环、指向材料或框架、重复连线都会被拒绝;从选中文字分出的线不能改接 |
| 模型下拉里没有 Agent 分组 | 页面不是通过本地代理打开的,或本机没装 codex / claude。菜单里会写明没找到哪个命令、在哪些目录找过 |
| 多模型对照的运行按钮是灰的 | 至少要选两个模型,问题也不能为空 |
双链笔记压缩包在终端里用 unzip 解压,中文文件名乱码 | macOS 自带的 unzip 不认文件名的 UTF-8 标记。双击压缩包解压,或用 ditto -x -k 文件.zip 目标目录 |
终端 Agent 报 NO_SERVER 或 NO_CANVAS | 前者是本地代理没启动;后者是画布没打开,或宿主交接面板里没勾选"允许本机 Agent 编辑此画布" |
终端 Agent 报 REVISION_CONFLICT | 它读取画布之后你又改过。让它重新读一遍再改 |
附:实测数据与覆盖范围
主流程(13 步)
| 步骤 | 结果 | 耗时 |
|---|---|---|
| 模型配置 | 已登录提供商,12 个模型可用 | — |
| 第一问(默认模型,带思考过程) | 回答 1461 字,约 1238 tok | 58.3 秒 |
| 追问 | 回答 1331 字;下一轮将发送 6 条消息、约 2414 tok | 48.2 秒 |
| 从第一问再开一条分支 | 发送内容仍是 4 条消息(不含另一条追问线) | 34.2 秒 |
| 剪掉分支的入线,再撤销 | 发送内容从 6 条消息降到 4 条;撤销后连线恢复 | — |
| 多模型对照:3 个模型 + 自动汇总 | 3 个分支全部答完,汇总节点有 3 条汇入连线 | 75.6 秒(含汇总) |
| Codex 写文件 | 在画布工作区新建了 weft-e2e.md,变更记录到节点 | 12.1 秒 |
| 导出双链笔记 / JSON 备份 | 9 个 Markdown 文件,压缩包校验通过 | 不到 1 秒 |
| 刷新页面 | 8 个节点全部保留 | — |
想在自己机器上复现:先启动上面两个服务,再运行
node scripts/e2e-user-journey.mjs evidence/weft-user-journey-$(date -u +%Y%m%dT%H%M%SZ)脚本会把截图、导出文件和 metrics.json 写进指定目录;哪一步失败,就会留下一张 fail-<步骤>.png。
单独验收的功能
| 功能 | 结果 | 验证脚本 |
|---|---|---|
| 发送前的完整请求、回执与"现已不同"、改接、插入一步、删除改为归档(第 6、7、10、11 节) | 35/35 项检查通过 | scripts/verify-context-visible.mjs |
| 判断模型给多模型分支打分、换个模型重答(第 5 节) | 18/18 项检查通过,答题模型和判断模型都是真实的托管模型 | scripts/verify-node-judge.mjs |
| 一键重放(第 12 节) | 13/13 项检查通过 | scripts/verify-replay-plan.mjs |
把 Agent 会话打开成图、/weft、凝练(第 14 节) | 17/17 项检查通过 | scripts/verify-local-atlas.mjs |
| 终端 Agent 直接改画布(Claude Code、Codex 各一次,第 15 节) | 各自读取 Skill、开分支、接引用、作答并写回,回执存进画布;45 秒 / 93 秒 | scripts/verify-real-host.mjs |
| 两个终端 Agent 同时改同一张画布 | 都完成任务;Codex 遇到一次冲突后重新读取完成;各自的输入里没有对方分支的内容;96 秒 / 130 秒 | scripts/verify-multi-agent.mjs |
第 6、7、10、11、12、14 节的验收用的是测试用的替身模型和合成会话,验证的是界面行为和实际发出的请求,不是回答质量。全部验收记录见仓库根目录的 VERIFICATION_ZH.md。
没有覆盖的范围
下面这些没有覆盖,不要当作已验证:
- 手动连线和接入材料(第 10、11 节):按应用内教程描述,不在主流程 13 步里。
- Claude Code 在画布里作为 Agent 节点运行:此前单独跑通过,不在主流程 13 步里。
- 终端 Agent 直接改画布,每个 Agent 只跑了一次,不代表其他模型同样稳定。
- SSO 登录的完整流程:测试时本机已登录,只验证了状态展示。
- "回答一次"和"持续评审"两种视角模式、阅读器、记忆与回忆、联网搜索。
- 桌面版、英文界面、Windows 和 Linux。